נתונים פתוחים לקידום הבריאות
באפריל השקנו את ״בינה מלאכותית למאבק באלצהיימר״, התוכנית הראשונה של OpenAI Foundation בתחום מדעי החיים וריפוי מחלות. היום אנו מציגים את תוכנית המדע השנייה שלנו: ״נתונים פתוחים לקידום הבריאות״.
בתוכנית ״בינה מלאכותית למאבק באלצהיימר״ אנו מתמקדים במחלה אחת שמשפיעה על משפחות רבות, ושאנו מאמינים שבינה מלאכותית יכולה לעזור למדענים לפתח טיפולים טובים יותר עבורה. בתוכנית ״נתונים פתוחים לקידום הבריאות״ אנו מתמקדים בקידום מדעי החיים והמחקר במחלות רבות, באמצעות מימון יצירה ושימור של מערכי נתונים מדעיים באיכות גבוהה, שיהיו זמינים לקהל רחב של חוקרים.
נתונים מדעיים הם תצפיות על העולם שסביבנו, חומר הגלם הבסיסי למחקר ולגילויים. בתחומים שבהם אפשר לאמת פריצות דרך ללא איסוף נתונים חדשים, כמו ענפים מסוימים במתמטיקה, מערכות בינה מלאכותית החלו לאחרונה לתרום ידע חדש. בביולוגיה, בינתיים, מערכות בינה מלאכותית מסוגלות יותר ויותר לנתח מידע ביולוגי בהיקף נרחב ולחשוף מבנים נסתרים גם מתוך ראיות חלקיות, לעיתים ביעילות מדהימה.
עם זאת, אנו צופים שפריצות דרך רבות שעוד צפויות במניעת מחלות ובטיפול בהן ינבעו משילוב בין היכולות של מודלים חדשים לבין תצפיות נוספות על העולם — במילים אחרות, עוד נתונים.
מערכי נתונים מסוימים בעלי ערך עצום לציבור עלולים לעולם לא להיווצר או להיות משותפים, משום שלשום מוסד יחיד אין תמריץ מספק או יכולת מספקת לממן אותם. לכן התמיכה בנתונים פתוחים לקידום הבריאות מתאימה במיוחד ל־OpenAI Foundation.
המענקים הראשונים שלנו
אנו מתחילים במתן מענקים בסך יותר מ־125 מיליון דולר לקבוצה ראשונה של ארגונים ללא כוונת רווח ואוניברסיטאות. המענקים מקיפים רבדים רבים של נתונים: ממולקולות, דרך אפידמיולוגיה ועד ידע רגולטורי.
הנה כמה דוגמאות לפרויקטים שאנו תומכים בהם:
OpenADMET ייצור מערכי נתונים פתוחים, מבחני ביצועים ותחרויות בהערכה סמויה כדי לבדוק אם אפשר לאמן מודלים של בינה מלאכותית לחזות כיצד מולקולות קטנות נספגות ומתפזרות בגוף. המטרה היא לצמצם את אי־הוודאות בפיתוח תרופות ולהפחית את שיעור הכישלון של תרופות חדשות.
90% מהמועמדות לפיתוח תרופה נכשלות בניסויים קליניים. לעיתים קרובות הדבר נובע מהקושי לחזות כיצד הן ייספגו וינועו בגוף — תכונות ה־ADMET שלהן. אתגרי חיזוי שטרם נפתרו, כמו זה, עשויים להתאים היטב לבינה מלאכותית, בשילוב נתונים באיכות גבוהה שיאפשרו לבסס את דיוק התחזיות של מודלים שונים. לדוגמה, AlphaFold2 חולל מהפכה בחיזוי מבני חלבונים באמצעות נתונים מ־Protein Data Bank, בתחרות מול גישות מידול אחרות שערך CASP. חיזוי מבני חלבונים משולב כיום בתוכניות רבות לגילוי תרופות, שסביר להניח שיועילו למטופלים בהמשך.
כדי לשפר את חיזוי תכונות ה־ADMET של מועמדות לפיתוח תרופה, צוות OpenADMET יפתח מערכי נתונים באיכות גבוהה שישמשו בסיס למודלי חיזוי חדשים, ויקיים תחרויות פתוחות לחוקרים מכל העולם.
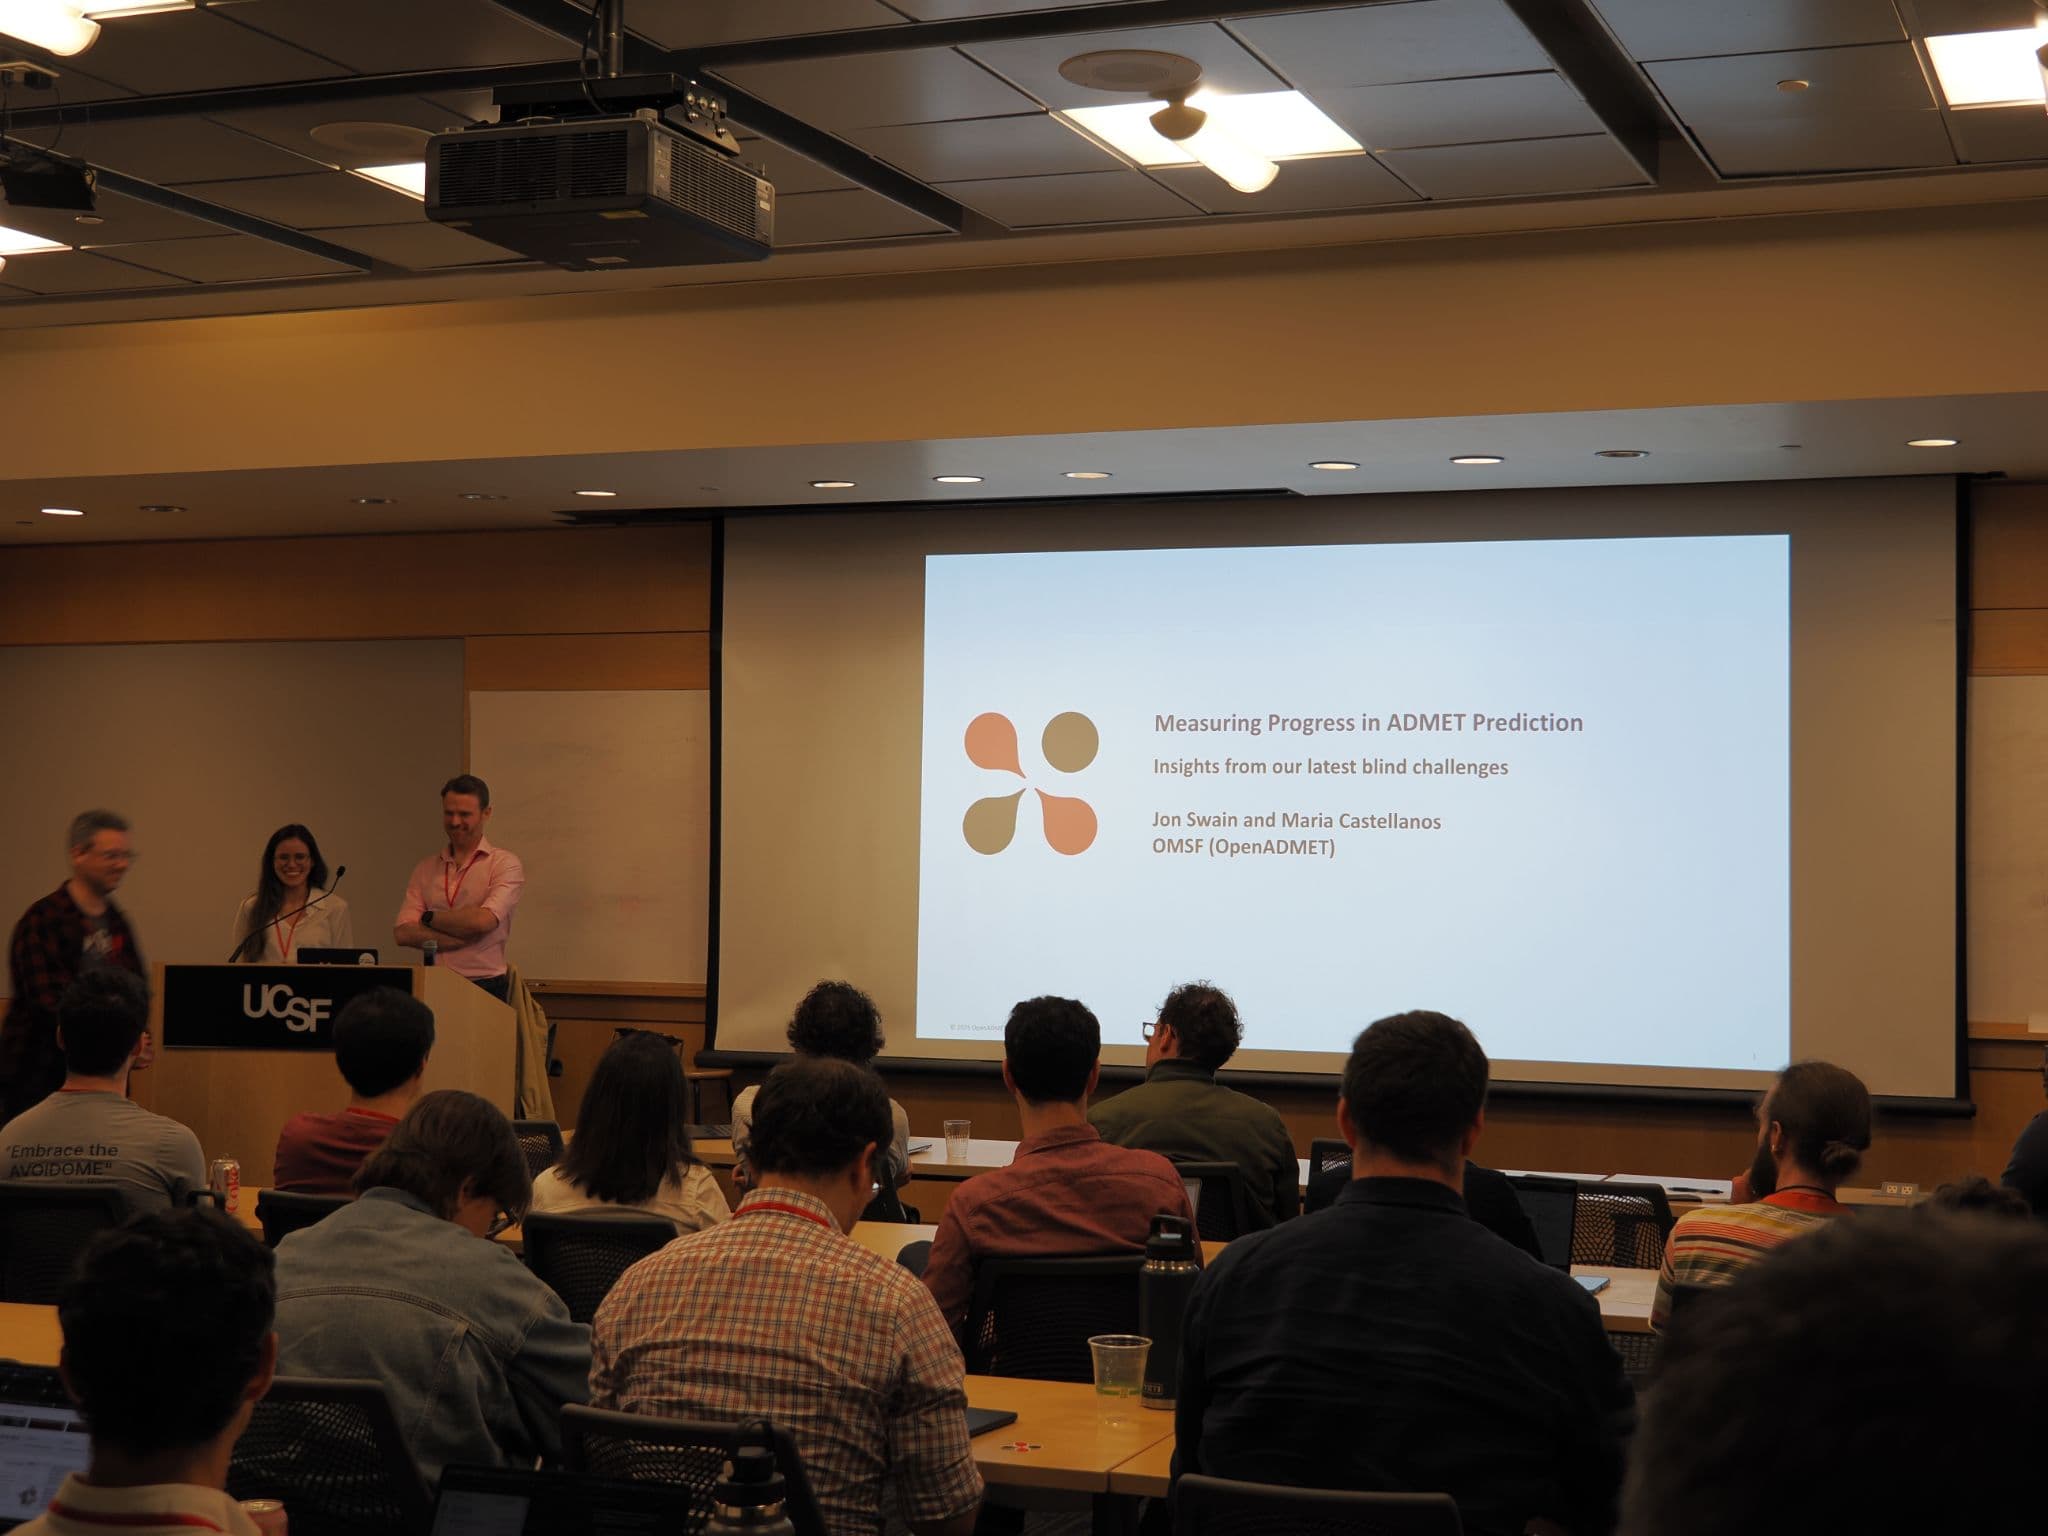
הרצאה באירוע של OpenADMET שנערך לאחרונה למשתתפים באתגרי חיזוי ADMET. קרדיט: נעמי הנדלי.
״תחום גילוי התרופות מלא בבעיות משותפות ששום חברה או מעבדה אקדמית המעוניינת לרפא מחלה מסוימת לא יכולה לפתור לבדה״, אמר ד״ר ג׳יימס פרייזר, חבר הוועד המנהל של OpenADMET ופרופסור וראש המחלקה להנדסה ביולוגית ולמדעי הטיפול התרופתי ב־UCSF. ״OpenADMET הוקם כדי להתמודד עם הבעיות האלה בגישה פתוחה ומותאמת ללמידת מכונה. אנו נרגשים מהאפשרות לבנות את התשתית שתאפשר לבינה מלאכותית להאיץ מאוד את פיתוחם של טיפולים חדשים.״
CTD Commons ישמר ויפרסם ידע רגולטורי מתוכניות פיתוח תרופות שנכשלו, כדי שצוותים עתידיים יוכלו ללמוד מניסיון קודם שבדרך כלל אינו נגיש, וכך לסייע לגלות מהר יותר טיפולים יעילים למטופלים.
CTD, או מסמך טכני משותף (Common Technical Document), הוא מסמך שמרכז את כל מסלול הפיתוח של תרופה ניסיונית — ממחקרי רעילות בבעלי חיים ופרטי הייצור ועד התכתבויות עם ה־FDA, שהן אולי החלק המועיל ביותר בו. אולם רק חלק קטן מהעבודה הזאת מופיע במאמרים שמתפרסמים.
CTD Commons יבחן את האפשרות לרכוש מסמכי CTD מתוכניות פיתוח תרופות שנכשלו או נגנזו, ולהנגיש אותם לכולם לצורכי מחקר וניתוח.
״כל הגשה ל־FDA מייצגת עבודה קשה והקרבה מצד חוקרים, בודקים ומשתתפי מחקר. גם כשהמאמצים האלה נכשלים, אסור שהמידע רב־הערך שנוצר בזכותם ירד לטמיון״, לדברי ג׳וש מוריסון, המוביל את הקמת CTD Commons ונשיא 1Day Sooner. ״CTD Commons יצמצם כפילות ועלויות, וימקסם את ההשפעה של המחקר הקליני.״
UNC תקים את היוזמה לאימונותרפיה גנרטיבית ותיצור נתונים רב־מודאליים פתוחים לציבור. המטרה היא לקדם עתיד שבו חולי סרטן יוכלו לקבל במהירות חיסונים מותאמים אישית נגד סרטן עם האבחון.
חיסוני הסרטן המבוססים על ״נאו־אנטיגנים״ הם כיום בין הטיפולים המעטים המתוכננים באופן חישובי לכל מטופל בנפרד, באמצעות ריצוף של תא גידול כדי לחזות אילו מטרות ייחודיות לגידול מוצגות על פניו. אבל הריצוף עצמו הוא מדד עקיף למציאות, משום שקשה ויקר למדוד ישירות את המטרות שעל פני התא, ועוד יותר מכך לבדוק באיזו עוצמה מערכת החיסון של המטופל מגיבה לכל אחד מהחלבונים האלה.
UNC תשלים את החוליות החסרות האלה במאות גידולים ובמגוון סוגי סרטן. כך היא תיצור את אחד ממערכי הנתונים הראשונים לאימון ולהערכה בתחום, עם נתונים נטולי פרטים מזהים שיהיו פתוחים לחוקרים מכל העולם ויוכלו לשמש בסיס לעבודתם.
״חיסונים מותאמים אישית נגד סרטן מתחילים סוף־סוף להראות סימנים של יעילות קלינית, אבל עדיין יש פערים שעלול לקחת עשרות שנים לסגור במתכונת המסורתית של פיתוח טיפולים. נתונים באיכות גבוהה יכולים לעזור לנו לסגור את הפערים האלה מהר יותר״, אמר ד״ר אלכס רובינשטיין, מרצה בכיר לגנטיקה בבית הספר לרפואה של UNC. ״אנו נרגשים מהאפשרות לקצר את התהליך הזה ולעזור להפוך טיפולים אימונותרפיים מותאמים אישית, בעלי יעילות רחבה, למציאות.״
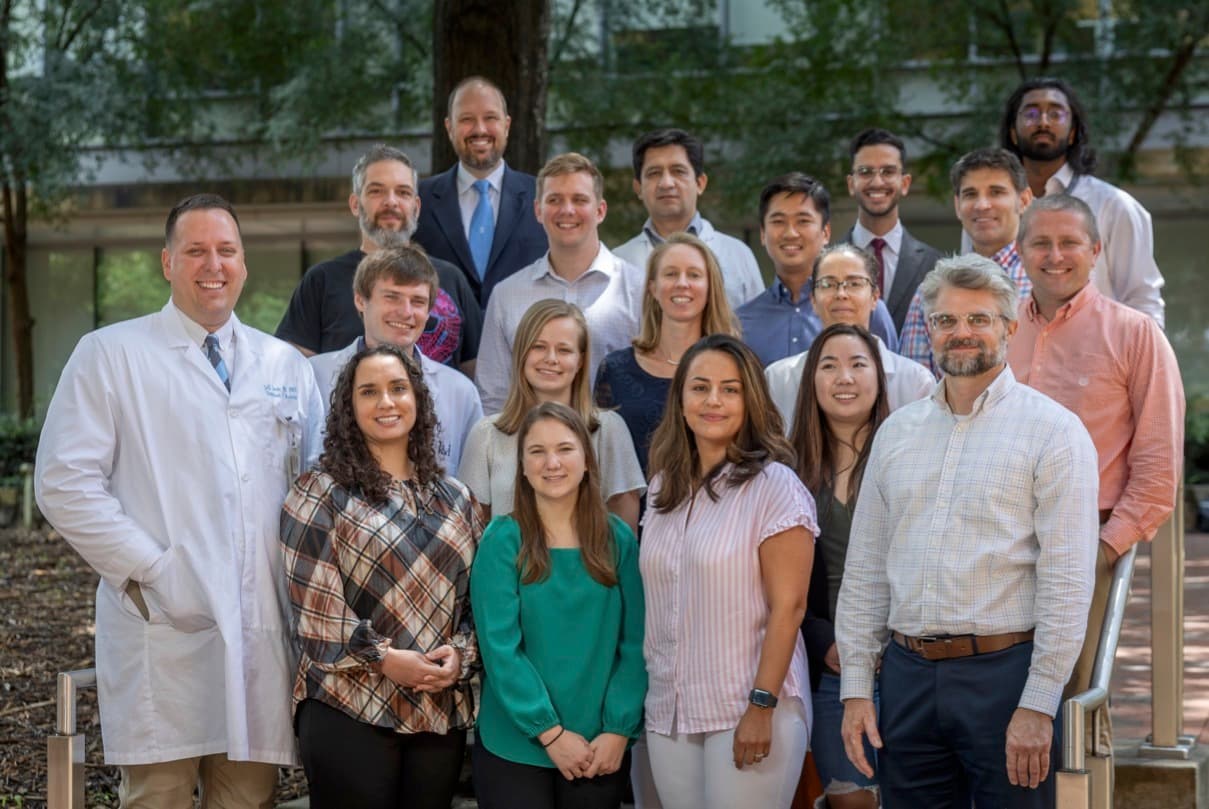
חברי מעבדה עובדים על חיסונים מותאמים אישית נגד סרטן באוניברסיטת קרוליינה הצפונית. קרדיט: UNC.
האסטרטגיה הראשונית שלנו
אנו צופים שחלק זה יהיה רלוונטי במיוחד לחוקרים המתעניינים בהזדמנויות עתידיות לקבלת מענקים מ־OpenAI Foundation.
כמות הנתונים המדעיים שכדאי לאסוף גדולה בהרבה ממה שכל גוף מממן יחיד יכול לתמוך בו. לכן רצינו לפרט כאן לקהילת המחקר באילו סוגי נתונים אנו מאמינים שהתמיכה של OpenAI Foundation יכולה להועיל ביותר.
הנחת המוצא שלנו היא שכדאי להתמקד בנתונים מקושרים, בנתונים נדירים ובנתונים ישירים . למערכי הנתונים שנממן יהיו בדרך כלל אחת או שתיים מהתכונות האלה, המתוארות בפירוט בהמשך, ובמקרים נדירים — כל השלוש.
בכל מערכי הנתונים, אנו מאמינים שיהיה חשוב יותר ויותר להפוך את הנתונים ל־נגישים לקהל רחב, תוך שמירה על פרטיות בכל הנוגע לנתוני מטופלים. כך חוקרים יוכלו להתבסס על עבודתם של עמיתיהם, והתקדמות מדעית תוכל לצמוח ממקומות בלתי צפויים.
נתונים מקושרים: מעקב אחר תהליכים ביולוגיים לאורך שלבים רבים
תהליכים ביולוגיים מתרחשים בקני מידה שונים, אך רוב מערכי הנתונים במדעי החיים מתעדים רק חלק אחד מהמציאות. אטלס תאים עשוי למדוד מולקולות באלפי תאים, ואילו דימות ברמת המולקולה הבודדת עוקב אחר תא אחד בלבד. שתי נקודות המבט חשובות, אבל מכיוון שמערכי נתונים כאלה נוצרים בדרך כלל בנפרד, ייתכן שיידרשו שנים של עבודת המשך כדי להבין כיצד הממצאים המדעיים קשורים זה לזה. אנו רוצים לתמוך בצוותי מחקר יחידים כדי שיוכלו לעבור באופן מכוון בין קני המידה האלה וליצור מערכי נתונים עשירים ומקושרים, שהרבדים השונים בהם מחזקים זה את זה.
לדוגמה, המענק שלנו ל־UCSF יאפשר לצוות OpenADMET למדוד תכונות מולקולריות ואינטראקציות מרכזיות בעשרות אלפי תרכובות. לאחר מכן הצוות יקשר בין האפיון הרחב הזה לבין שתי נקודות מבט על הובלת תרופות: מבנים של חלבוני הובלה שאליהם קשורות מולקולות נבחרות, שייקבעו בניסויים, ובדיקות שימדדו כיצד החלבונים האלה פועלים באינטראקציה עם המולקולות. לבסוף, הם יבדקו חלק מהתרכובות האלה במודלים של מחסום הדם־מוח האנושי, וישוו את התוצאות למדידות בבעלי חיים חיים.
גישה זו לאיסוף נתונים תיצור תמונה שלמה באופן יוצא דופן של הגורמים הקובעים את תנועת התרופה בגוף — תמונה שתאפשר למודלים של בינה מלאכותית לחזות טוב יותר ברמה החשובה לנו כבני אדם.
נתונים נדירים: לשמר את מה שלא ניתן לשחזר
שום בינה מלאכותית עתידית, מוכשרת ככל שתהיה, לא תוכל לחזור לאחור ולצפות באירועים ביולוגיים המתרחשים ברגעים מסוימים וייחודיים — כמו גורמי תמותה ותחלואה במדינות שאין בהן נתונים דמוגרפיים מהימנים, או הרכבן של דגימות ביולוגיות שנלקחו ממטופלים ברגעים מסוימים שכבר חלפו. הביולוגיה מלאה בהזדמנויות כאלה שלא יחזרו, ומפתחי מודלים בעתיד עשויים למצוא שימושים לראיות האלה שחוקרים אינם יכולים לצפות כיום. לכן אנו מעוניינים במיוחד בהצעות שיאספו או ישמרו נתונים בעלי ערך לפני שההזדמנות תחלוף, או ינגישו לקהל רחב מערכי נתונים פרטיים קיימים שלעולם לא ניתן יהיה ליצור מחדש, תוך כיבוד הפרטיות והסכמתם של הנוגעים בדבר.
לדוגמה, המענק שלנו ל־CTD Commons יאפשר לבדוק אם ניתן להציל את התיעוד של תוכניות פיתוח תרופות שנכשלו, לפני שהחברות נסגרות והתיעוד נעלם. בטווח הקצר, המסמכים האלה עשויים לעזור לצוותים בשלבים מוקדמים של פיתוח תרופות להבין מה דרשו הרגולטורים ממוצרים דומים, במקום ללמוד זאת בתהליך יקר של ניסוי וטעייה. בטווח הארוך, המסמכים עשויים לשמש מערכות למידת מכונה לזיהוי דפוסים בסיבות לכישלון או להצלחה של תרופות. כך הם יוכלו לסייע בשיפור הרגולציה או אסטרטגיות הניסויים, ולאפשר למטופלים ליהנות מטיפולים חדשים מוקדם יותר.
נתונים ישירים: מדידת מצבים ביולוגיים וקליניים הקרובים ביותר למה שחשוב
לאורך חלק גדול מההיסטוריה של הביולוגיה, המחקר התמקד במדידת מה שהיה קל או זול למדוד. למשל: איסוף נתונים על תאים בודדים במקום נתונים קליניים מבני אדם, או מדידת ביטוי RNA במקום חלבונים. המדדים העקיפים האלה הועילו מאוד, אבל הם גם עלולים לאבד את הקשר למטרות של הבנת הביולוגיה, מניעת מחלות וטיפול בהן. במקרים כאלה, אנו רוצים לתת לחוקרים את המשאבים הדרושים להרכבת מערכי נתונים שמודדים את הדברים החשובים ביותר. ייתכן גם שהמכשור הדרוש למדידת ״האמת הביולוגית״ עדיין אינו קיים, או שהשימוש בו בהיקף נרחב יקר מכדי להיות מעשי. במסגרת התוכנית הזאת, אנו מקווים לתמוך בשני הכיוונים — נתונים חדשים וכלים חדשים.
לדוגמה, המענק שלנו ל־UNC להקמת היוזמה לאימונותרפיה גנרטיבית יאפשר לצוות ב־UNC Lineberger וב־UNC Health להפיק את הנתונים המבוססים על בני אדם שנחוצים לשיפור הדור הבא של חיסוני הסרטן. המשמעות היא מדידה ישירה של החלבונים שעל פני תאי הגידול, וכן של תגובות תאי ה־T של המטופלים, במקום ״רק״ לרצף את הגידול. הפקת הנתונים האלה יקרה; באמצעות הפקתם באופן מקיף הפעם והנגשת התוצאות לכולם, אנו מקווים שכל מאמצי הפיתוח העתידיים של חיסוני סרטן יוכלו ליהנות מהם. בפרט, אם הפרויקט יצליח, חיסונים מועמדים עתידיים יוכלו להגיע לשלב המתן לבני אדם עם קבוצת מטרות מבטיחה יותר. הדבר אמור לשפר את סיכויי ההצלחה שלהם, ולהגדיל את היקף הידע שניתן להפיק כשהם אינם מצליחים.
להבטיח שהנתונים נגישים לחוקרים
לבסוף, בכל המענקים שלנו אנו דואגים שמערכי הנתונים שייווצרו יהיו נגישים ככל האפשר לחוקרים ברחבי העולם.
לאורך חלק גדול מההיסטוריה של המדע, בדיקת השערות הייתה אחד החסמים המרכזיים בדרך לגילויים. כמות ״כוח החשיבה״ הזמין לפתרון בעיות הייתה מוגבלת — מספר נתון של סטודנטים לתארים מתקדמים ומדענים מקצועיים, שהפיקו נתונים וניתחו אותם סביב בעיה מסוימת. ההתקדמות המתמשכת של הבינה המלאכותית בכתיבת קוד ובניתוח נתונים משנה את הנחת היסוד הזאת. ייתכן שיהיה אפשר להרחיב מאוד את היקף ניתוח הנתונים, ותובנות יצמחו משיתופי פעולה שקשה לחזות בזמן הפקת הנתונים.
המשימה שלנו היא להבטיח שבינה מלאכותית כללית תועיל לאנושות כולה. נתונים מדעיים שנוצרים בתמיכתנו צריכים להיות זמינים לקהל רחב, תוך שמירה על פרטיות הפרט ועל הסכמתו בכל מקרה שבו מדובר בנתונים על בני אדם. אבל נגישות אינה מסתכמת בפרסום הנתונים הגולמיים. אנו מעודדים את מקבלי המענקים לפרסם את הניתוחים שלהם במאמרים בגרסאות קדם־פרסום, לשתף נתונים באופן שוטף ולא רק בסיום, ואם הנתונים שלהם אינם ״מקושרים״ — לעבוד יחד עם משתמשי הנתונים כדי להעריך את התועלת שלהם בסוגיות בעלות חשיבות ביולוגית.
למידה בסבבים
הפוסט הזה מציג את הכיוון הראשוני שלנו בתוכנית ״נתונים פתוחים לקידום הבריאות״. אנו מעדכנים את תפיסותינו באופן פעיל עם ההתקדמות במדע ובבינה המלאכותית, ומתוך שיחות עם עמיתים בקהילת המחקר.
אם יש לכם רעיונות לתוכנית ״נתונים פתוחים לקידום הבריאות״, נשמח שתיצרו קשר בכתובת [email protected]. אפשר להירשם לניוזלטר שלנו כאן, כדי לקבל עדכונים על התוכניות והמימון שלנו.
אם מעניין אתכם לעסוק במשרה מלאה בבעיות כמו אלה שנדונו בפוסט הזה, אנו מגייסים כעת ל־ארבע משרות פתוחות בצוות מדעי החיים וריפוי מחלות.